Cześć wszystkim,
po części o kontach, MFA i zatwierdzaniu zmian wracam do repozytoriów. Tym razem sprawdziłem Application Backup Repository, czyli ABR - nową funkcję VBR 13.1 dla aplikacji, które same tworzą backup i zapisują go na NFS.
Zamiast zaczynać od Oracle RMAN, wybrałem prostszy przykład: PostgreSQL w kontenerze LXC na Proxmoxie. Chciałem przejść od zapisu dumpu, przez snapshot i drugą kopię, aż do odtworzenia bazy. Przy okazji sprawdziłem, co się stanie po uszkodzeniu pliku na aktywnym udziale.
🗄️ Co ABR dodaje do zwykłego NFS?
Aplikacja nadal wykonuje własny backup. W tym teście PostgreSQL zapisywał dump, a w przypadku Oracle kopię może przygotowywać RMAN. Veeam udostępnia miejsce na te pliki i zajmuje się snapshotami, ich retencją oraz niezmiennością. Starszy stan można udostępnić pod osobną ścieżką albo cofnąć do niego bieżący udział. Dane ABR można też objąć Backup Copy do repozytorium VBR, a następnie kopią na taśmie.
ABR działa na Veeam Infrastructure Appliance w roli Hardened Repository, z pulą ZFS przygotowaną dla tej funkcji. Każda aplikacja powinna mieć własne ABR - dokumentacja wymaga takiego rozdzielenia. Dzięki temu można osobno ustawić harmonogram, retencję i dostęp do danych.
Veeam nie sprawdza tutaj, czy dump zakończył się poprawnie. Jeśli snapshot obejmie plik w trakcie zapisu, zachowa właśnie taki stan. Dlatego harmonogram trzeba uzgodnić z backupem aplikacji. W skrypcie użytym pod koniec testów zapis trafiał najpierw do pliku tymczasowego. Dopiero po poprawnym zakończeniu eksportu plik otrzymywał docelową nazwę. Ten mechanizm przygotowałem w skrypcie - ABR nie wykonuje go za aplikację.
Producent wymienia między innymi Oracle RMAN Incremental Merge, eksporty aplikacji oraz kopie konfiguracji urządzeń. Mój test dotyczył dumpów PostgreSQL, nie integracji z RMAN.
🛠️ Przygotowanie VIA i repozytorium
Konfiguracja zaczyna się w Host Management Console. Na VIA wdrożonym jako Hardened Repository w sekcji Backup Infrastructure wysyłamy żądanie włączenia roli Application Backup Repository. Jeżeli skonfigurowano Security Officera, musi je zatwierdzić. Bez SO rola jest włączana od razu. To jeden z praktycznych przykładów rozdzielenia uprawnień opisanego w poprzedniej części.
Następnie w Storage przygotowujemy pusty dysk i pulę dla ABR. Po dodaniu appliance do VBR uruchamiamy kreator New Application Backup Repository: wybieramy host, pulę, nazwę udziału, uprawnienia NFS oraz harmonogram snapshotów. Szczegóły są w procedurze wdrożenia.
W moim laboratorium VIA zostało zainstalowane z ISO 13.1.0.411, a następnie zaktualizowane do 13.1.1.18. VBR działał na osobnym VSA w tym samym buildzie. Maszynie z VIA przydzieliłem dysk systemowy 128 GiB i osobny dysk danych 256 GiB. HMC pokazało pulę o pojemności użytkowej 254 GB. Repozytorium nazwałem VUG-ABR-REPO i ustawiłem 7 dni retencji snapshotów.
Podczas konfiguracji trafiłem na kilka drobiazgów, które mogą oszczędzić komuś szukania:
- Nazwa abr-data została odrzucona przez HMC. Nazwa abrdata, bez łącznika, została przyjęta (tylko znaki alfanumeryczne są dozwolone).
- Po utworzeniu puli karta Devices nadal pokazywała Not mounted. W Volumes było już widać aktywny magazyn w grupie Application Backup Storage.
- W klasycznej konsoli VBR widziałem osobny węzeł ABR. W Web UI 13.1.1.18 nie było go w widoku zwykłych repozytoriów. Kreator standardowego repozytorium Linux nie służy do dodawania ABR.
Pierwsza próba zapisania uprawnień NFS zakończyła się też błędem certyfikatu zdalnego hosta. Pomogło ponowne przejście przez kreator edycji hosta VIA w Web UI i zainstalowanie certyfikatów klienta. Nie wyłączałem walidacji TLS ani Multi-Admin Approval. Po tej operacji mogłem zapisać regułę ReadWrite dla klienta testowego. To obserwacja z tego laboratorium, nie uniwersalna procedura naprawy błędów certyfikatów.
🔑 Uprawnienia i snapshoty
Dostęp do udziału ograniczyłem do jednego adresu IP. Przy pustej liście uprawnień serwer odmawiał zamontowania udziału. Po dodaniu ReadWrite zapis i odczyt działały.
Sprawdziłem również Read. Klient nadal pokazywał w findmnt opcję rw, ale próba utworzenia pliku kończyła się komunikatem Read-only file system. Odczyt i kontrola SHA-256 działały. Po przywróceniu ReadWrite znów mogłem zapisać plik. Sama opcja montowania nie wystarcza więc do sprawdzenia uprawnień - trzeba wykonać próbę zapisu.
Przy dostępie opartym na hoście lub IP Veeam obsługuje NFSv3, v4.1 i v4.2. Kerberos wymaga NFSv4.1 lub v4.2 oraz dołączenia hosta ABR do domeny. Dla systemowego klienta NFS w Windows dokumentacja wskazuje NFSv3. W tym teście użyłem NFSv4.2 bez Kerberosa.
W kreatorze trzeba jeszcze zaznaczyć Create repository snapshots. Sam działający udział nie oznacza, że powstaje historia danych. Oprócz ręcznych snapshotów sprawdziłem harmonogram - kolejny punkt utworzył się automatycznie o północy.
🐧 PostgreSQL w LXC
Wybrałem LXC, ponieważ Veeam Plug-in for Proxmox VE nie obsługuje backupu tych kontenerów. ABR pozwala chronić dump utworzony przez aplikację w kontenerze, ale nie jest backupem całego LXC. Nie odzyskamy w ten sposób jego konfiguracji, systemu ani zainstalowanych pakietów.
Pierwsza próba bezpośredniego zamontowania udziału NFS z nieuprzywilejowanego kontenera Ubuntu 24.04 zakończyła się Operation not permitted, również po ustawieniu mount=nfs,nesting=1. W uprzywilejowanym kontenerze testowym próba montowania dotarła już do serwera, który sprawdził uprawnienia ABR. Dalsze próby wykonałem w tym drugim wariancie.
Nie traktowałbym tego jako zalecenia, żeby zmieniać istniejące kontenery na uprzywilejowane. Inną możliwością jest zamontowanie udziału NFS na hoście Proxmox i przekazanie katalogu jako bind mount, ale tego wariantu nie sprawdzałem. Wymaga on uwzględnienia uprawnień, mapowania UID/GID i migracji kontenera. Zawartość bind mountu nie jest obejmowana kopią vzdump.
Trzy wersje bazy i cofnięcie udziału
Przygotowałem testową bazę PostgreSQL. Wykonałem trzy kolejne eksporty jej zawartości do pliku, czyli dumpy, które oznaczyłem literami A, B i C. Przed każdym kolejnym eksportem dodawałem do bazy nowe rekordy, żeby później sprawdzić, czy odzyskałem dane z właściwego momentu. Zapisałem sumy kontrolne plików oraz wyniki zapytań do porównania po odtworzeniu. Po zapisaniu każdego dumpu tworzyłem snapshot ABR.
Najpierw użyłem Instant Export dla snapshotu A. Starsze dane pojawiły się pod inną ścieżką NFS, tylko do odczytu. Suma kontrolna pliku była zgodna z oryginałem. Odtworzyłem z niego osobną bazę i potwierdziłem, że zawierała dane z chwili wykonania pierwszego eksportu.
Potem sprawdziłem Revert Snapshot, czyli cofnięcie aktywnego udziału. Po powrocie do A nie było na nim plików B i C, a pliki A pozostały zgodne z zapisanymi hashami. Kolejny Revert do zachowanego snapshotu C przywrócił komplet A/B/C. Tutaj sprawdzałem stan plików na udziale; nie odtwarzałem ponownie bazy bezpośrednio po operacji Revert.
Do odczytania starszego dumpu wybrałbym Instant Export. Revert zmienia bieżącą zawartość udziału, więc wymaga zatrzymania zapisów aplikacji i zaplanowanego okna na zmianę.
📦 Backup Copy i odtworzenie z drugiej kopii
Zadanie VUG-ABR-COPY utworzyłem w klasycznej konsoli przez Backup Copy → Image-level backup, dodając ABR jako źródło. Nazwa pozycji menu może zmylić - w tym przypadku kopiowane są dane repozytorium aplikacyjnego, nie obraz kontenera.
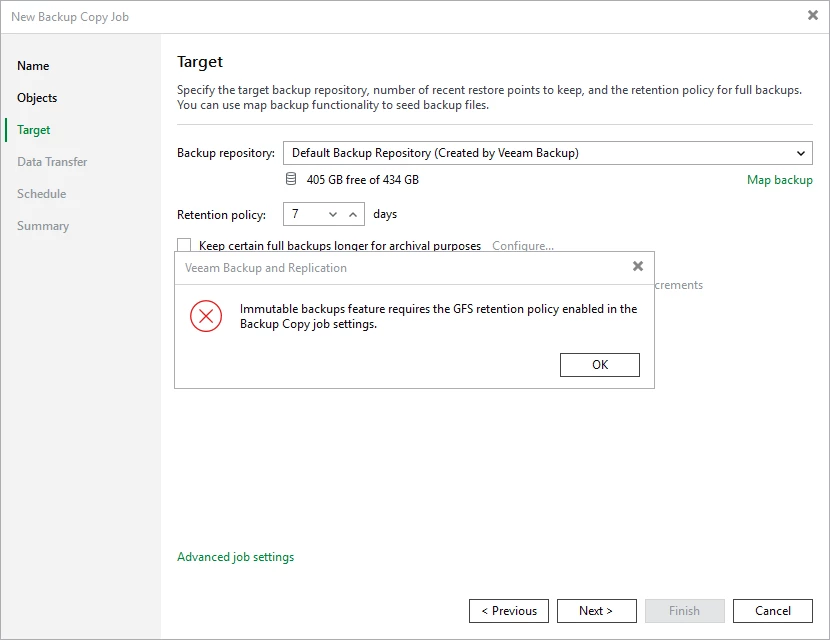
Wybrałem tryb Immediate, transport Direct i Default Backup Repository na osobnym VSA. Dla tego repozytorium docelowego kreator nie pozwolił przejść dalej bez włączonego GFS. Ustawiłem 7 dni retencji i jeden tygodniowy punkt GFS. Wymóg GFS dotyczył repozytorium docelowego z immutability, a nie samego źródłowego ABR. Ustawienie 1 weekly było wyborem na potrzeby tego testu.
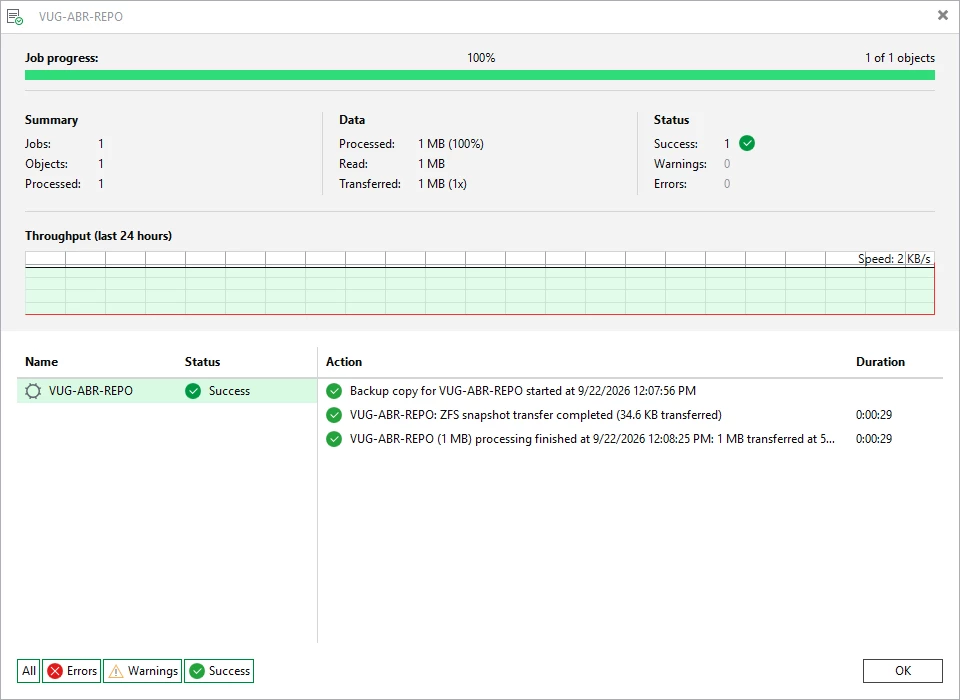
Kopia zakończyła się bez ostrzeżeń i błędów. W logu było widać transfer snapshotu ZFS. Zestaw danych był mały, więc nie wyciągam z tego wyniku wniosków o wydajności.
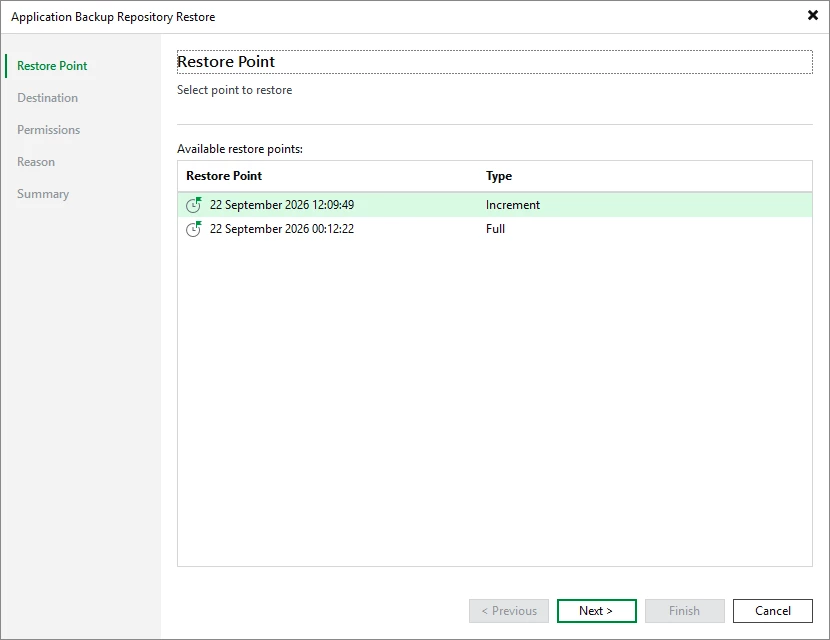
W Disk (Copy) wybrałem Instant recovery i punkt przyrostowy z 22 września 2026 r., godz. 12:09:49. Veeam opublikował tymczasowy udział NFS na ABR-REPO01. Zamontowałem go na kliencie z opcją ro, czyli tylko do odczytu, sprawdziłem sumy kontrolne plików i odtworzyłem każdy dump do osobnej bazy PostgreSQL. W tej sesji ograniczenie narzuciłem po stronie klienta; nie była to próba blokady zapisu przez serwer.
Wszystkie trzy wersje udało się odtworzyć. W każdej bazie sprawdziłem liczbę rekordów i zgodność ich zawartości z danymi zapisanymi przed backupem. Zgadzały się również sumy kontrolne plików. Nie poprzestałem więc na statusie Success w Veeam - sprawdziłem, czy odzyskane pliki dają się wykorzystać i zawierają właściwe dane. Bazy testowe odtwarzałem na tej samej instancji PostgreSQL; nie było to odtworzenie całego serwera.
Po odtworzeniu trzeba zakończyć udostępnianie danych
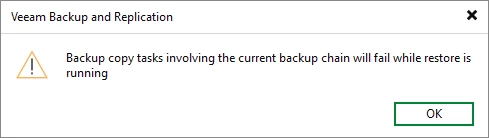
Przed uruchomieniem recovery Veeam ostrzegł, że zadania Backup Copy używające tego łańcucha będą kończyć się błędem podczas odtwarzania.
Sesja pokazała najpierw Exclusive access acquired, później Share created successfully i Waiting for user action. Ten ostatni stan nie oznaczał błędu. Udział był dostępny i czekał na zakończenie pracy.
Po odmontowaniu klienta zatrzymałem publikację. Sesja zakończyła się Stopped / Success, a kolejna synchronizacja Backup Copy również przeszła poprawnie. Zamknięcie samego okna sesji nie zastępuje Stop publishing.
Uszkodzony dump i nowa wersja D
W następnej próbie zabezpieczyłem plik C, po czym zmieniłem jego pierwszy bajt na aktywnym udziale. SHA-256 się zmienił, a pg_restore odrzucił dump jako nieprawidłowe archiwum. Nie zmieniałem danych w zablokowanym snapshocie.
Poprawny plik pobrałem z udziału udostępnionego z Backup Copy. Miał pierwotną sumę kontrolną SHA-256 i tym razem odtworzenie bazy się powiodło. Liczba rekordów i suma kontrolna ich zawartości zgadzały się z wynikami zapisanymi przed uszkodzeniem.
Na koniec dodałem do bazy nowy rekord i wykonałem kolejny dump, oznaczając plik literą D. Po utworzeniu snapshotu powstał kolejny punkt przyrostowy Backup Copy. Odtworzyłem z niego bazę i sprawdziłem, że zawiera również nowy rekord. Liczba rekordów oraz sumy kontrolne pliku i danych były zgodne. To potwierdziło, że po wcześniejszym recovery kopiowanie objęło również nowo zapisane dane.
Podczas udostępniania dumpu D sprawdziłem jeszcze równoległy dostęp do bieżących i starszych danych. Zapis kontrolnego pliku do bieżącego udziału działał, natomiast udział odzyskany z kopii, z regułą Read po stronie serwera, odrzucał zapis mimo zamontowania go na kliencie z opcją rw. Nowy plik nie pojawił się w historycznym eksporcie. Po próbie usunąłem plik kontrolny, odmontowałem oba udziały i zakończyłem publikację. Końcowa synchronizacja kopii również zakończyła się sukcesem.
⚠️ Co trzeba uwzględnić przed wdrożeniem?
ABR korzysta z lokalnej przestrzeni dyskowej VIA. Nie obsługuje przechowywania swoich danych na zdalnych urządzeniach FC ani iSCSI. Według dokumentacji Veeam, sprawdzonej 22 września 2026 r., każde ABR wykorzystuje jedną instancję licencji VUL w Veeam Data Platform Advanced lub Premium. Licencjonowanie według gniazd procesorów (socketów) nie jest obsługiwane.
Wymagania sprzętowe Veeam, sprawdzone tego samego dnia dla buildu 13.1.1.18, podają minimum 4 rdzenie (vCPU) o częstotliwości co najmniej 1 GHz, 8 GB RAM i dysk systemowy 120 GB. Przestrzeń na dane trzeba zapewnić osobno; potrzebna ilość pamięci może być większa, zależnie od ilości chronionych danych. Przy planowaniu pojemności zwróciłbym uwagę na dwa progi: powyżej 80% zajętości puli może spaść wydajność, a przy 97% zatrzymuje się tworzenie snapshotów. Trzeba zostawić miejsce na zmiany danych przez cały okres ich retencji, nie tylko na kolejny plik backupu.
Do odzyskania danych z Backup Copy potrzebny jest host z rolą Application Backup Repository. Samo repozytorium z plikami kopii nie wystarczy. Veeam pozwala wskazać inny host ABR, co ma znaczenie po utracie oryginalnego serwera. W opisanych próbach publikowałem dane na źródłowym ABR-REPO01. Nie wykonałem jeszcze testu z wyłączonym źródłowym hostem, więc nie traktuję tych wyników jako potwierdzenia pełnej procedury DR.
Nie sprawdziłem też próby usunięcia snapshotu w czasie blokady ani pełnego cyklu wygaśnięcia 7-dniowej retencji. Oracle RMAN, Kerberos i kopia na taśmie pozostają poza zakresem tego laboratorium.
W Release Notes jest ponadto znany problem: przerwanie sieci podczas transferu snapshotu może trwale zatrzymać zadanie kopii błędem Source snapshot is already present in target dataset. Nie wywoływałem go w tym teście. Warto go uwzględnić przy ocenie konkretnego buildu i planowaniu testów awaryjnych.
💬 Gdzie widzicie miejsce dla ABR?
Widzę tu przede wszystkim zastosowanie dla aplikacji, która już ma sprawdzony sposób tworzenia dumpu, ale zapisuje go na zwykłym udziale NFS. ABR dodaje do tego snapshoty i drugą kopię, bez zmiany samego narzędzia backupowego. W moim przypadku udało się z tych plików odtworzyć bazę PostgreSQL, również po celowym uszkodzeniu bieżącego dumpu.
Korzystacie już z ABR, szczególnie z Oracle RMAN Incremental Merge? Interesuje mnie też, czy sprawdzaliście odtworzenie z Backup Copy na innym hoście ABR, bez dostępu do źródłowego repozytorium.
🔗 Źródła
- What’s New - Enterprise Application and Database Protection
- Application Backup Repository - ograniczenia
- VBR 13.1 Release Notes
- Wymagania systemowe ABR
- Wdrożenie i zatwierdzenie roli ABR w HMC
- Dodawanie ABR w VBR
- Ustawienia repozytorium i dostępu NFS
- Harmonogram snapshotów
- Ograniczenia Veeam Plug-in for Proxmox VE, w tym brak obsługi LXC
- Proxmox pct - bind mount NFS w LXC i granice backupu
- Tworzenie Backup Copy dla Application Backup Repository
- Wymagania Backup Copy
- Wybór hosta do odzyskania ABR z kopii