Introdução
Eu vinha lidando com um problema intermitente nos backups VMware, difícil de explicar com base em uma única sessão com falha. Um job podia ser concluído com sucesso em uma execução e falhar na seguinte, apresentando a mesma mensagem: DiskLib error 13, seguida de uma falha ao criar um fluxo de download NFC.
Durante a investigação, percebi que as falhas faziam parte de um problema operacional mais amplo. Os jobs de backup estavam se sobrepondo, algumas sessões aguardavam recursos e movimentações de DRS tornavam-se perceptíveis durante a execução dos backups. Além disso, snapshots de armazenamento permaneciam após as atividades de backup, enquanto a capacidade física do storage se aproximava do limite.
O ambiente possuía 27 jobs de backup VMware, com agendamentos de execução a cada hora e mais de 300 VMs. Para contextualizar as versões, o ambiente estava executando Veeam Backup & Replication 13.0.1.1071, VMware vCenter 8.0.3 e um IBM FlashSystem FS5200.
A investigação me levou a reavaliar como os jobs compartilhavam hosts, datastores e volumes de armazenamento. Discutir os requisitos de proteção com o administrador de infraestrutura foi tão importante quanto analisar o próprio erro. As mudanças realizadas combinaram a execução paralela entre três grupos de datastores com a execução sequencial dos jobs dentro de cada grupo.
O problema
O erro original ocorreu enquanto o Veeam preparava uma VM para processamento. O trecho abaixo preserva a mensagem original, substituindo os identificadores da infraestrutura por rótulos genéricos e ajustando as linhas longas para facilitar a leitura:
Failed to prepare VM for processing: DiskLib error: [13].The file is locked or in use -- File open failed: File not open
Failed to create NFC download stream.
NFC path: [nfc://conn:[VCENTER],nfchost:[HOST-ID],stg:[DATASTORE-ID]@[VM]/[VM].vmx].
Agent failed to process method {Transfer.FileToText}.
A falha apareceu em diferentes jobs de backup VMware, mas não em todas as execuções. Sessões concluídas com sucesso e sessões com falha coexistiam. Isso tornou menos evidente a possibilidade de um problema persistente de configuração, embora a intermitência, por si só, não descartasse problemas que afetassem hosts específicos ou caminhos de acesso.
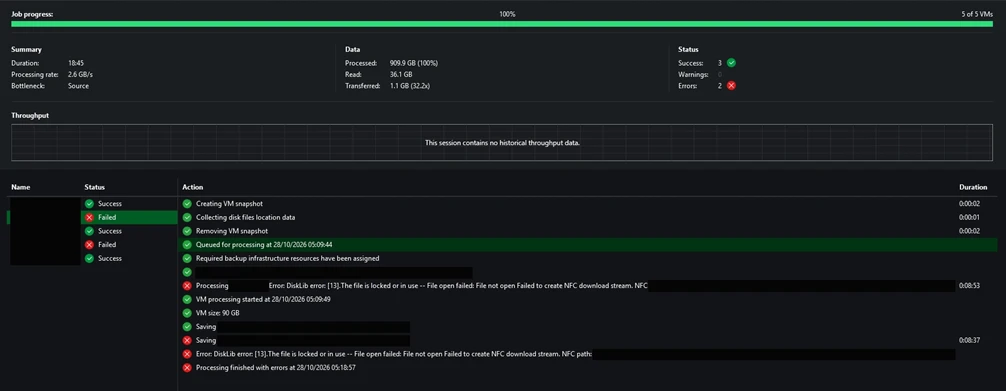
Uma sessão ilustra por que precisei olhar além da barra de progresso: ela terminou com três tarefas de VM bem-sucedidas e duas tarefas com falha. O progresso havia atingido 100%, mas duas VMs não foram protegidas com sucesso naquela sessão.
Investigação
Além da sessão com falha
Os jobs possuíam agendamentos independentes, e muitos estavam ativos simultaneamente. Os limites de tarefas já estavam configurados, mas esses limites não transformavam a carga de trabalho combinada em ciclos sequenciais completos de backup e limpeza.
Algumas sessões processavam dados enquanto outras aguardavam recursos ou concluíam outras operações. A espera por recursos é uma consequência esperada de um limite de tarefas; por si só, ela não comprova que a infraestrutura esteja sobrecarregada.
A observação importante foi a combinação de execuções simultâneas, falhas intermitentes, snapshots de armazenamento retidos e pouca capacidade física disponível.
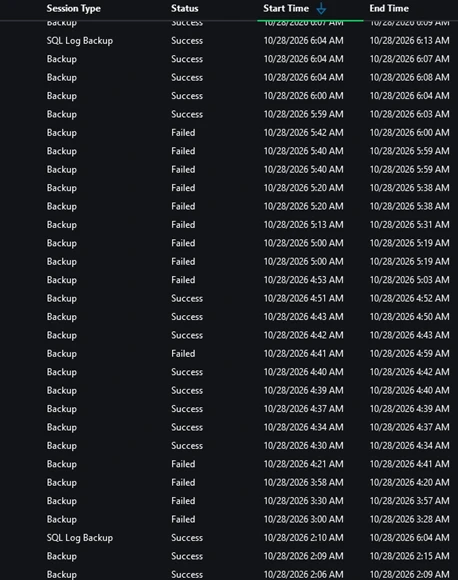
A questão passou a ser como organizar esses jobs de maneira que seus horários e escopos refletissem a infraestrutura compartilhada entre eles.
Investigando a atividade do DRS
Também observei atividades de DRS durante a execução dos backups.
Nesse contexto, DRS refere-se ao posicionamento das VMs e ao balanceamento de recursos computacionais entre os hosts ESXi, utilizando o vMotion para realizar migrações entre hosts.
Isso é diferente do Storage DRS e do Storage vMotion, que estão relacionados ao posicionamento e à migração de armazenamento.
Essas movimentações foram uma pista útil, mas não consegui relacionar uma migração específica a um determinado bloqueio de arquivo.
Para estabelecer essa relação, seria necessário conhecer o host em que a VM estava no momento da falha, os horários das migrações, o host responsável pela solicitação NFC e as evidências que identificassem o proprietário do bloqueio.
Portanto, o DRS permaneceu como parte da investigação, e não como uma causa confirmada. Uma atividade normal de vMotion, isoladamente, não representa evidência de que algo esteja errado.
Quando a capacidade de armazenamento se tornou crítica
Os snapshots de armazenamento permaneciam após as atividades de backup, e a capacidade passou a ser a preocupação mais urgente.
A visualização anterior do storage mostrava 19,68 TiB utilizados fisicamente, de um total de 19,94 TiB, com apenas 267,90 GiB disponíveis: aproximadamente 98,7% de utilização física.
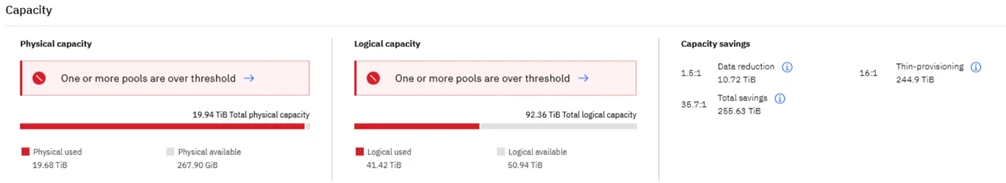
Valores de capacidade conforme a visualização original do storage.
Naquele momento, precisei considerar conjuntamente o fluxo de trabalho dos backups, o ciclo de vida dos snapshots de armazenamento e a capacidade física disponível.
Um job concluído com sucesso, isoladamente, não resolveria o risco operacional mais amplo.
Análise técnica
O que o erro NFC realmente indicava
NFC significa Network File Copy nesse contexto do VMware.
A mensagem original apontava para um arquivo de configuração .vmx. Na Figura 1, o salvamento do arquivo .vmx foi concluído, enquanto o acesso ao arquivo .nvram falhou.
Esses foram exemplos de falhas durante a leitura de arquivos de configuração ou de estado da VM.
A mensagem associada informava que o arquivo estava bloqueado ou em uso.
A documentação Veeam KB1198 descreve essa família de erros e diferencia DNS, conectividade, permissões e bloqueios de arquivos como possíveis caminhos de investigação.
A mensagem completa é mais importante do que interpretar o número 13 isoladamente.
Isso não comprovava corrupção de discos virtuais nem identificava o responsável pelo bloqueio.
Também não identificava o transporte utilizado para ler os VMDKs: um erro NFC envolvendo um arquivo de configuração não é prova de que os dados dos discos estavam sendo lidos por NBD ou de que ocorreu um fallback de transporte.
Dois ciclos de vida de snapshots
O recurso Backup from Storage Snapshots envolve tanto snapshots VMware quanto snapshots na camada de armazenamento.
De maneira simplificada, o fluxo de trabalho para um grupo ou lote funciona da seguinte forma:
-
Criar snapshots VMware para as VMs que serão processadas.
-
Capturar um snapshot de armazenamento do volume ou LUN correspondente.
-
Remover os snapshots VMware.
-
Ler os dados das VMs a partir do snapshot de armazenamento.
-
Remover o snapshot temporário de armazenamento após o processamento.
Portanto, o snapshot VMware pode já ter sido removido enquanto o snapshot de armazenamento ainda é necessário.
A remoção bem-sucedida do snapshot VMware, apresentada na Figura 1, não comprovava que a limpeza do armazenamento havia sido concluída.
Reavaliando o modelo de dependência dos snapshots
Durante a investigação, utilizei uma analogia entre elementos pai e filho para explicar os snapshots retidos.
A parte útil dessa explicação era a possibilidade de existirem dependências. O ponto que precisava de correção era tratar VMs individuais como elementos pais ou filhos.
Se o FlashCopy estivesse em uso, os objetos relevantes seriam os volumes de origem e destino e seus respectivos mapeamentos.
As dependências podem exigir que os dados sejam preservados ou copiados antes que um relacionamento seja interrompido ou removido com segurança.
A existência de vários snapshots de um mesmo volume, por si só, não comprova uma falha de limpeza nem estabelece a cadeia exata de dependências.
Existe também uma distinção importante na integração com a IBM.
A Veeam KB4650 explica que configurações compatíveis podem utilizar a funcionalidade de snapshot de volume do storage em vez do FlashCopy, incluindo seleção automática em sistemas que oferecem suporte a esse recurso.
O firmware, as capacidades do equipamento e a implementação do plug-in são fatores importantes.
Apenas identificar o modelo FS5200 não é suficiente para determinar qual mecanismo foi utilizado por um job.
Minha hipótese era que atividades simultâneas sobre volumes compartilhados contribuíam para prolongar a permanência dos snapshots e tornar a limpeza mais complexa.
Para confirmar um mecanismo específico de dependência, seriam necessárias as versões do firmware IBM e do plug-in, as relações entre os objetos do storage e os logs de limpeza.
Três controles diferentes de concorrência
Considerei importante separar três controles que podem parecer intercambiáveis, mas possuem funções distintas:
-
Limites de tarefas dos proxies e repositórios: controlam a quantidade de operações executadas simultaneamente nesses componentes.
-
Agendamento dos jobs: determina quando diferentes fluxos de trabalho entram em execução.
-
Quantidade de VMs por snapshot de armazenamento: controla como as VMs são divididas em lotes de snapshots.
O último controle merece atenção especial.
A documentação atual do Veeam descreve o processamento paralelo desses lotes.
Um lote menor pode reduzir o tempo durante o qual os snapshots VMware permanecem abertos, mas também introduz snapshots adicionais no storage.
Isso não garante que exista apenas um snapshot ativo por LUN.
Não tenho o registro histórico da configuração dessa opção neste caso.
O objetivo do projeto era coordenar as operações sobre o armazenamento compartilhado, mantendo um nível adequado de concorrência para o ambiente.
A solução
Reorganizando o agendamento de acordo com os requisitos de proteção
Antes de alterar a organização dos jobs, conversei com o administrador de infraestrutura sobre os requisitos de proteção dos servidores.
Precisávamos entender quais cargas de trabalho exigiam proteção mais frequente e como o agendamento dos backups poderia atender a essas necessidades.
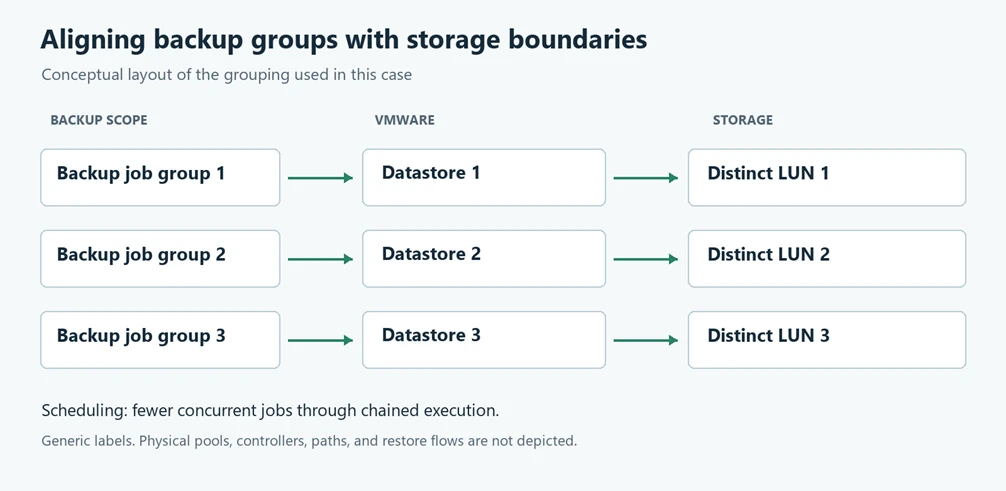
Organizei os jobs em três cadeias, uma para cada datastore e seu respectivo LUN subjacente.
As três cadeias eram executadas em paralelo. Dentro de cada cadeia, um job era iniciado somente após a conclusão do seu antecessor.
Essa organização preservou a execução paralela entre os três grupos, ao mesmo tempo que reduziu a sobreposição de jobs que acessavam o mesmo LUN.
Isso não serializou todo o ambiente de backup e representou uma estratégia de agendamento, não um mecanismo de bloqueio na camada de armazenamento.
Backups executados a cada hora não eram necessariamente o problema. A questão era se a carga de trabalho combinada conseguia ser concluída de forma confiável diante dos recursos disponíveis.
O encadeamento de jobs possui algumas desvantagens.
Uma execução mais longa ou novas tentativas podem atrasar os jobs seguintes, afetar o calendário dos backups completos e deixar outros recursos subutilizados.
A documentação do Veeam descreve essas limitações e apresenta os limites de tarefas como outra maneira de equilibrar a carga da infraestrutura.
O encadeamento foi a abordagem utilizada neste caso; não se trata de uma recomendação universal para executar todos os jobs de backup de forma sequencial.
Alinhando os jobs aos limites dos datastores e LUNs
Trabalhando em conjunto com o administrador, também reorganizei os grupos de VMs entre três datastores, cada um sustentado por LUNs diferentes.
Segui esses mesmos grupos ao organizar os jobs de backup.
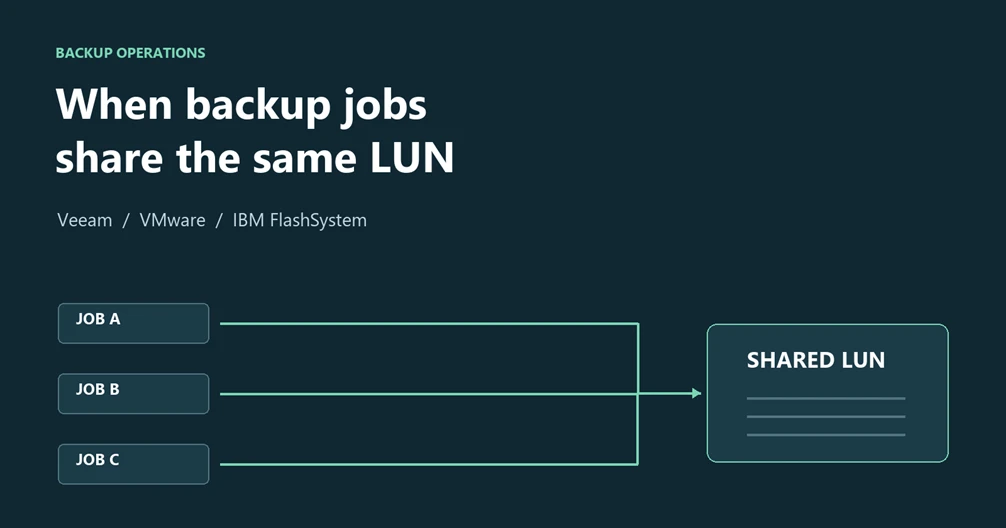
Anteriormente, jobs com agendamentos independentes podiam operar simultaneamente sobre VMs que compartilhavam o mesmo LUN subjacente.
Na organização revisada, o agrupamento dos jobs passou a seguir a estrutura dos datastores e LUNs.
Cada grupo possuía sua própria cadeia sequencial, executada paralelamente às cadeias dos outros dois datastores.
O projeto final utilizou grupos de VMs por datastore, em vez de concentrar todas as VMs em um único datastore.
As orientações de integração de storage do Veeam recomendam a organização dos jobs com base nos datastores e também abordam a utilização de jobs paralelos para manter a taxa de transferência.
O objetivo prático era coordenar as operações de snapshot sobre volumes compartilhados, aproveitando de maneira eficiente a infraestrutura disponível.
Dois pontos ainda precisam ser considerados ao aplicar essa abordagem.
Primeiro, é necessário verificar o posicionamento de todos os arquivos e VMDKs relevantes das VMs. Discos localizados em outros LUNs podem manter a sobreposição entre os grupos.
Segundo, LUNs diferentes ainda podem compartilhar o mesmo pool, controladoras, cache, discos ou caminhos de acesso.
Organizar as atividades de snapshot não significa criar recursos físicos independentes.
Tratando o acúmulo existente
Os objetos que já haviam se acumulado precisaram de uma atenção específica.
O administrador de infraestrutura realizou uma limpeza manual por meio da CLI do storage, identificando os objetos com base na convenção de nomenclatura utilizada pela integração do Veeam.
Não tenho o histórico dos comandos nem um inventário que mostre exatamente quais tipos de objetos foram removidos.
Essa limpeza foi uma ação separada das alterações de agendamento e organização dos jobs.
Não posso descrevê-la como um procedimento de remoção de snapshots ou FlashCopy devidamente verificado.
Um prefixo de nomenclatura, isoladamente, não comprova que um objeto esteja sem uso ou que possa ser excluído com segurança.
A reprodução de uma limpeza desse tipo exige a verificação dos objetos reais, suas dependências e o procedimento oficialmente suportado.
Resultados
Durante aproximadamente três semanas após a correção, não observei a recorrência do erro NFC nem do acúmulo de snapshots retidos.
As três cadeias de jobs por datastore continuaram sendo executadas em paralelo, com os jobs organizados sequencialmente dentro de cada cadeia.
Essa observação ocorreu após a combinação das alterações e da limpeza manual realizada pelo administrador.
Ela representa um período de observação operacional, e não permite isolar o efeito individual de cada ação.
As visualizações de capacidade registradas permitem uma comparação numérica.
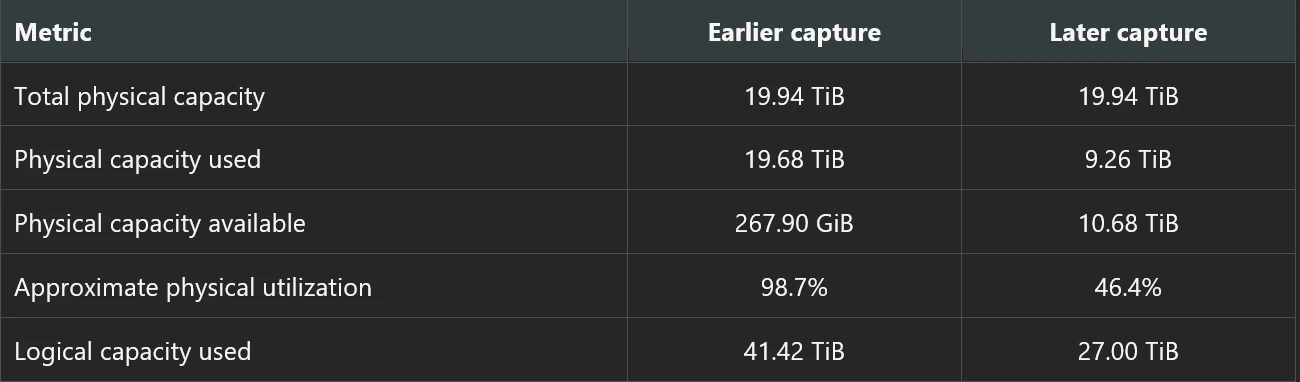
Os valores de capacidade foram transcritos diretamente da interface. O total e a capacidade utilizada são apresentados em TiB, com precisão decimal limitada, enquanto o valor anterior de capacidade disponível é apresentado em GiB.
Por esse motivo, subtrair os valores arredondados em TiB não necessariamente reproduzirá o valor de capacidade disponível exibido separadamente.
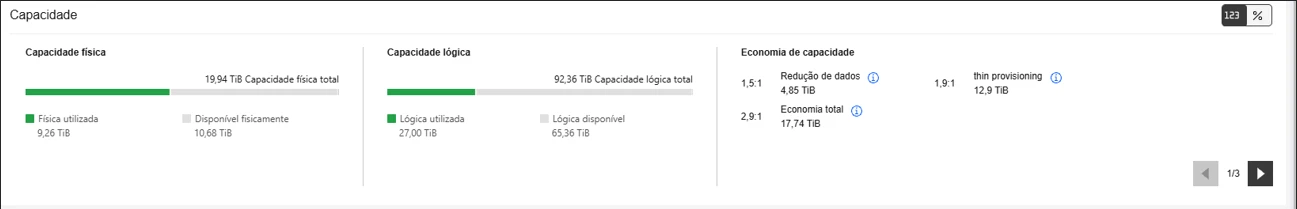
A utilização física apresentada na interface caiu aproximadamente 10,42 TiB, representando uma redução de 52,9% em relação à capacidade utilizada anteriormente.
Essa é uma comparação de capacidade, não uma medição de melhoria de desempenho nem uma atribuição de todo o espaço liberado aos snapshots.
As duas visualizações não isolam o efeito da limpeza manual de outros fatores.
Elas demonstram a diferença geral na utilização física apresentada pelo storage.
Não é possível reconstruir os objetos exatos removidos nem a sequência de limpeza a partir dessas capturas.
É importante destacar algumas limitações:
-
Não tenho uma série contabilizada de sessões que permita calcular a taxa de falhas antes e depois das alterações.
-
Não foi identificado o responsável pelo bloqueio do arquivo.
-
O mecanismo exato de dependência do storage não foi confirmado.
-
Não tenho os números das versões do firmware IBM e do plug-in.
-
Os registros também não incluem um teste de restore nem medições de RPO/RTO.
A conclusão sustentada pelas evidências é que nenhum dos dois sintomas voltou a ocorrer durante aproximadamente três semanas de observação após as ações combinadas, e a posição de capacidade física apresentada pelo storage melhorou significativamente.
Lições aprendidas
-
Comece pela operação que falhou. Um erro de acesso a um arquivo de configuração exige uma investigação diferente de uma falha de leitura de disco virtual ou de gravação no repositório.
-
Analise os agendamentos como uma carga de trabalho combinada, incluindo novas tentativas, preparação e limpeza.
-
Diferencie filas de recursos esperadas de evidências de demanda excessiva ou contínua.
-
Acompanhe os snapshots VMware e os snapshots de armazenamento separadamente, incluindo criação, tempo de permanência, processamento e remoção.
-
Alinhe os grupos de jobs ao posicionamento real dos arquivos e discos das VMs e, em seguida, coordene a concorrência de acordo com os recursos compartilhados por esses grupos.
-
Verifique as consequências do encadeamento dos jobs para as cargas de trabalho seguintes, os agendamentos de backups completos e os requisitos de pontos de recuperação.
-
Registre o período de observação e o resultado da limpeza dos snapshots. Esses registros tornam muito mais fácil explicar e comprovar a estabilização do ambiente.
Conclusão
A mudança mais importante na minha abordagem foi avaliar os jobs de backup como uma carga de trabalho combinada da infraestrutura.
O erro NFC intermitente motivou a investigação, mas o problema mais amplo envolvia agendamento, operações VMware, snapshots de armazenamento e capacidade física.
Trabalhar em conjunto com o administrador de infraestrutura me ajudou a organizar os jobs de acordo com os requisitos de proteção e o layout do armazenamento.
As três cadeias paralelas preservaram a concorrência entre os grupos de datastores, enquanto a execução sequencial dos jobs dentro de cada cadeia reduziu a sobreposição de operações sobre o mesmo LUN.
O administrador também tratou o acúmulo existente por meio de uma limpeza manual independente.
Durante aproximadamente três semanas, nenhum dos dois sintomas voltou a ocorrer. A visualização posterior também demonstrou uma capacidade física disponível significativamente maior.
Os mecanismos exatos de bloqueio e dependência do storage continuam sem confirmação neste relato.
Ainda assim, a lição operacional é clara: o escopo e o momento de execução dos backups integrados ao storage precisam refletir os recursos compartilhados entre eles, e a validação deve considerar a limpeza e a capacidade de armazenamento, além do status dos jobs.
Se você já investigou erros NFC semelhantes, quais evidências ajudaram a relacionar a falha de acesso ao arquivo com atividades de migração de hosts ou de limpeza do storage?